Как сделать говорящий аватар нейросетью: синхронизация губ и голоса
Говорящий аватар — это видео, в котором статичная фотография оживает: персонаж двигает губами в такт речи, меняет мимику и выглядит так, будто действительно произносит заданный текст. Технология синхронизации губ и голоса (lip sync) стала доступна благодаря нейросетям, которые анализируют аудиодорожку и автоматически анимируют лицо. В этом гайде разберём, как работают современные модели для создания говорящих аватаров, какие задачи они решают и как сделать своё первое видео в CreatorHub AI.
Как работает синхронизация губ и голоса
Нейросеть для говорящего аватара принимает на вход статичное изображение лица и аудиофайл с речью. Модель анализирует фонемы — отдельные звуки речи — и сопоставляет их с положением губ, языка и челюсти. Затем генерирует последовательность кадров, в которых движения рта совпадают с произносимыми словами. Современные архитектуры учитывают не только артикуляцию, но и темп речи, паузы, эмоциональную окраску, что делает результат естественным.
Ключевая сложность — сохранить идентичность персонажа: форму губ, расположение зубов, текстуру кожи. Ранние модели создавали «усреднённый рот», который хорошо синхронизировался с речью, но не принадлежал конкретному человеку. Новые подходы, такие как Reference-Grounded Oral Refinement (RGOR), используют эталонные кадры того же персонажа и обучают модель отличать его рот от чужого, что повышает точность передачи индивидуальных черт.
Основные метрики качества
- Sync-C — точность синхронизации губ с речью, измеряется через сравнение визуальных и аудиофич;
- FID и FVD — оценивают визуальное качество и плавность движения;
- LPIPS — перцептивная близость к реальному видео;
- IQA — общее качество изображения;
- ASE — стабильность эмоциональной экспрессии.
По данным arxiv.org, модель Kandinsky S2V 1.0 Pro показывает лидирующие результаты по синхронизации губ в сравнении с коммерческими сервисами, получая предпочтение в 54–62% случаев в пользовательских оценках.
Обзор актуальных моделей для говорящих аватаров
Kandinsky S2V 1.0
Семейство моделей от российской лаборатории, представленное в октябре 2026 года. Включает две версии: Lite (2 млрд параметров) и Pro (21 млрд параметров). Модели генерируют видео 25 FPS из одного изображения, аудио и текстового промпта. Архитектура основана на Kandinsky 5.0 Video и использует трёхуровневую визуальную память с учётом референса, а также адаптивную лицевую функцию потерь. Обучение проводилось на корпусе из 1,17 млн клипов с одним говорящим, с подписями на английском и русском языках. Согласно arxiv.org, Kandinsky S2V 1.0 Pro сопоставима или превосходит сильнейшие open-source и коммерческие модели по средним оценкам, особенно в синхронизации губ. Дистиллированная версия Pro работает за 16 шагов без classifier-free guidance, обеспечивая ускорение в 5,4 раза при сохранении или улучшении метрик.
Hallo-Live
Фреймворк для генерации аватаров в реальном времени, представленный в апреле 2026 года командой Fudan Generative Vision. Использует каузальную двухпоточную DiT-архитектуру для синхронной генерации видео и речи в потоковом режиме. По данным github.com, Hallo-Live достигает 20,38 FPS с задержкой 0,94 секунды на двух NVIDIA H200 GPU, сохраняя высокую точность синхронизации губ, визуальное качество и качество речи. Модель поддерживает KV-кеш для аудио и видео, что позволяет эффективно работать в авторегрессивном режиме.
HeyGen Avatar v4
Коммерческая нейросеть для создания говорящих аватаров, анонсированная в сентябре 2026 года. Превращает фотографию в видео с синхронизированной речью, учитывая темп, паузы и артикуляцию. Согласно sostav.ru, HeyGen Avatar v4 предлагает выбор AI-голосов или загрузку собственного аудио, рекомендует чёткую запись без фоновой музыки и эха. В пользовательских оценках HeyGen Avatar v4 опережает Kandinsky S2V 1.0 Pro по визуальному качеству и естественности движений, но уступает в синхронизации губ.
LiveSync
Фреймворк итеративного самообучения для генерации lip-sync, представленный в октябре 2026 года. Модель обучается на реальных видео с масками, затем генерирует псевдопары — редактирует рот в исходных кадрах, используя независимо выбранное аудио, и дообучается на этих данных. По данным arxiv.org, LiveSync показывает лидирующую синхронизацию на датасете HDTF и конкурентные результаты на AIGC-LipSync при низкой задержке инференса.
Как сделать говорящий аватар в CreatorHub AI
Проект CreatorHub AI объединяет Telegram-бот @CreatorHubAI_bot и веб-приложение eazium.ru, предоставляя доступ к 40+ моделям для генерации изображений, видео, звука и обработки контента. Для создания говорящих аватаров используется раздел AI-аватары, который позволяет анимировать статичное фото с синхронизацией губ и голоса.
Пошаговая инструкция
- Откройте бот @CreatorHubAI_bot в Telegram и нажмите кнопку «Старт». Регистрация не требуется — вход выполняется одной кнопкой, без email и пароля. На старте вам доступно 20 бесплатных кредитов, которых хватит на первое видео.
- Перейдите в раздел «Аватары» через главное меню бота. Этот раздел содержит инструменты для анимации лица и создания говорящих аватаров.
- Загрузите фотографию персонажа. Выбирайте изображение с чётко видимым лицом, хорошим освещением и минимальными перекрытиями (например, без солнцезащитных очков или маски).
- Добавьте аудио или текст. Вы можете загрузить готовую аудиозапись с речью или ввести текст, который будет озвучен встроенным синтезатором голоса. Для лучшего результата используйте чёткую запись без фоновой музыки и эха.
- Выберите модель генерации. CreatorHub AI поддерживает несколько вариантов анимации, включая быструю генерацию и режимы с повышенным качеством. Для первого опыта рекомендуем начать с быстрой модели.
- Запустите генерацию. Бот обработает запрос и вернёт видео, в котором персонаж произносит заданную речь с синхронизированными движениями губ и мимикой.
Стоимость генерации зависит от выбранной модели и длительности видео. Быстрые модели для аватаров обычно требуют от 8 кредитов (примерно 11–14 ₽) за короткий ролик. Более сложные модели, такие как Kling 3.0 или Veo 3.1, стоят от 33 и 72 кредитов соответственно, но для говорящих аватаров они избыточны. Один кредит стоит примерно 1,4–1,7 ₽.
Советы для качественного результата
- Используйте качественное исходное фото: высокое разрешение, прямой ракурс, нейтральное выражение лица упрощают задачу модели.
- Подготовьте аудио: записывайте речь в тихом помещении, избегайте реверберации и фоновых шумов. Если используете синтез голоса, проверьте, что текст не содержит опечаток.
- Экспериментируйте с промптами: некоторые модели позволяют задать эмоциональную окраску или стиль движения через текстовое описание.
- Проверяйте синхронизацию: если губы отстают или опережают речь, попробуйте другую модель или отредактируйте аудио (уберите длинные паузы в начале).
Дополнительные инструменты обработки, такие как удаление фона, апскейл и реставрация, доступны в разделе «Обработка» бота и помогут улучшить исходное изображение перед анимацией.
Сравнение подходов и выбор модели
Для коротких роликов с акцентом на синхронизацию губ подойдут модели типа Kandinsky S2V или LiveSync — они быстро работают и точно передают артикуляцию. Если важна визуальная детализация и естественность мимики, стоит обратить внимание на HeyGen Avatar v4 или дистиллированную версию Kandinsky S2V 1.0 Pro, которая сочетает скорость и качество. Для потоковых приложений и интерактивных сценариев оптимален Hallo-Live с его низкой задержкой.
В CreatorHub AI доступны несколько вариантов генерации аватаров, различающихся скоростью и стоимостью. Новичкам рекомендуем начать с быстрых моделей — их хватит на первое знакомство с технологией и оценку результата. Более продвинутые режимы потребуют больше кредитов, но обеспечат детализацию и плавность движений на уровне коммерческих сервисов.
Примеры: как это выглядит на самом деле
Пример сделан нашим сервисом — промпт указан, результат можно повторить:
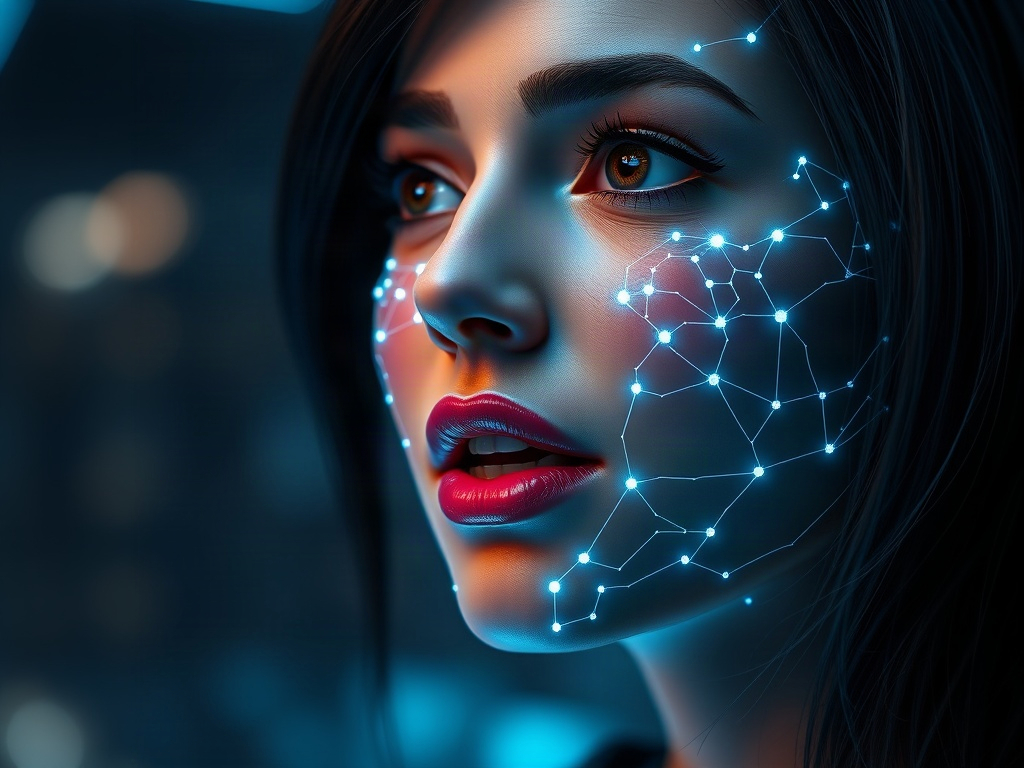 FLUX Schnell. Промпт: «A photorealistic 3D digital avatar of a woman speaking, with glowing neural network patterns overlaying her face, highlighting synchronized lip movements, cinematic lighting, futuristic tech style»